
发布时间:2026-09-09 17:36:04作者:贝玩下载编辑部阅读:次
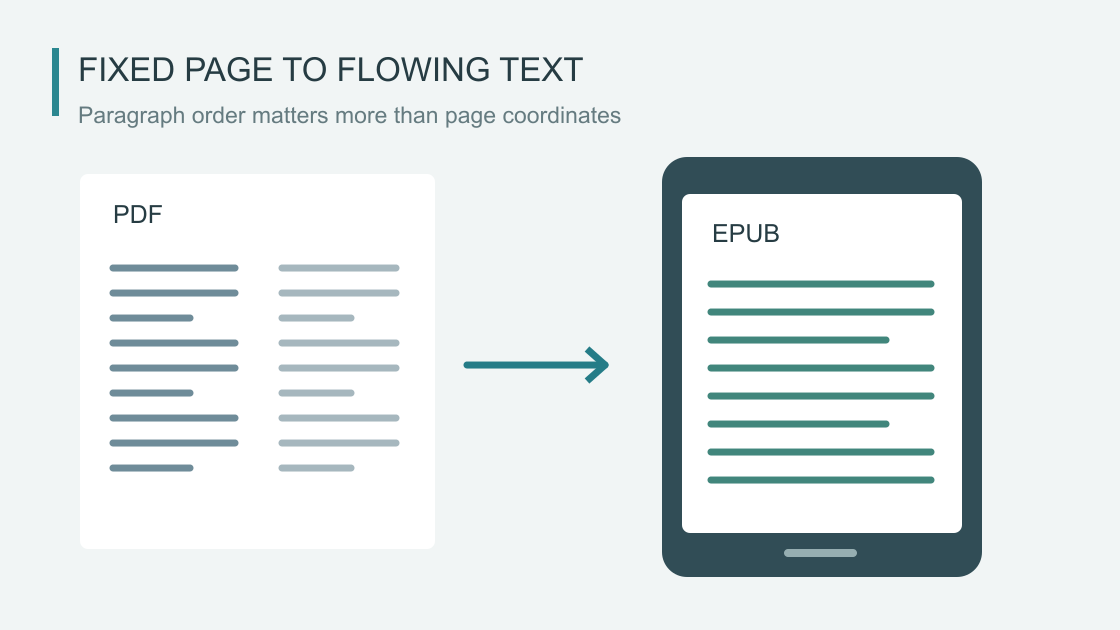
一本PDF在电脑上看着整整齐齐,转成EPUB后却每行都断开,页码还挤进了句子。这不一定是字号设置有误。PDF偏向保存固定页面上的文字位置,而流式电子书需要明确的段落顺序;转换程序必须从原有布局中推断结构,复杂版面自然更难还原。
calibre官方手册把PDF列为不理想的转换输入。若同时拥有同一本书的EPUB、文档或其他结构更清楚的源文件,优先从这些版本开始,通常比反复修补PDF转换结果更值得尝试。先确认源文件质量,也能避免把时间全花在并不相关的字体设置上。
在原PDF里试着选中并复制一小段文字,是检查文本情况的起点。纯图片扫描页不能仅靠普通格式转换变成可靠正文;带文字识别层的扫描件也可能出现看起来正确、复制出来却有错字的情况。官方说明指出,遇到这类文件,转换使用的是识别文本,而不一定是肉眼看到的页面内容。
对单栏文字稿,可以先观察输出中的断行和页眉页脚。PDF输入设置提供行展开参数,用来调整哪些行尝试合并;反复出现的页眉页脚则可通过查找替换处理。每次只改一个问题并对照前后结果,不要同时打开一串修复选项,否则段落改善了还是正文被误删了,很难判断。
抽查时除了正文第一页,还应找跨页段落、章节开头和含表格的页面,看看阅读顺序、空行与内容是否完整。双栏、复杂公式和图表本来就是困难场景,官方列出的PDF输入限制也包括复杂多栏文档和表格提取;一页转换漂亮,不能代表整本书都适合流式重排。
如果主要需求是完整阅读教材或保留图文对应,继续使用原PDF可能更合适。只有确认正文结构基本可靠后,再微调字号、边距和段间距,并在实际阅读设备上复查。另存转换结果、保留原稿,能让后来发现的漏字或错序仍有清楚的对照依据。
 电脑实用工具合集

 神雕侠侣2 v1.0.139.0安卓版
 樱花校园模拟器 v1.048.08安卓版
 360手机助手 v10.13.12安卓版
 英语流利说 v6.5.1安卓版
 西瓜视频 v10.6.4安卓版
 手机qq音乐2026 v9.13.0.5安卓版
 足球联盟2026 v1.0.1679安卓版
 掌上看家 v5.9.1安卓版
 无期迷途 v2.4.67.0安卓版